

llms.txt erstellen: Anleitung mit Prüfliste für Hersteller
Eine llms.txt ist eine Textdatei in Markdown, die KI-Systemen die wichtigsten Seiten einer Website nennt. Sie ist schnell angelegt. Ob KI-Suchen sie lesen, ist offen. In den Server-Logs von eom.de haben die geprüften Crawler von OpenAI und der Googlebot sie vom 29. Oktober bis 13. November 2026 von keiner bestätigten Adresse abgerufen.
Kurz gesagt
Eine llms.txt ist eine Textdatei in Markdown, die KI-Systemen die wichtigsten Seiten einer Website nennt. Sie wählen diese Seiten aus, schreiben sie als Links mit kurzer Notiz in die Datei, speichern sie unter ihre-domain.de/llms.txt und prüfen den Abruf. Auf eom.de haben die geprüften Crawler von OpenAI und der Googlebot sie in gut zwei Wochen von keiner bestätigten Adresse abgerufen.
- bestätigte Seitenabrufe von GPTBot, OAI-SearchBot und Googlebot auf eom.de, dazu 0 Abrufe der llms.txt (29.10. bis 13.11.2026)
- 2.521
- zufällig aus Wikidata gezogenen deutschen Herstellern mit 250 bis 5.000 Beschäftigten hatten am 11.11.2026 eine llms.txt
- 16 von 100
- dieser Dateien stammen erkennbar aus einem Shopsystem, einem Baukasten oder einem SEO-Plugin
- 7 von 16
- Pflichtangabe laut Vorschlag, die Überschrift mit dem Namen der Website (llmstxt.org)
- 1
Stand 13. November 2026. Die Belege und unsere Messmethode stehen am Ende des Beitrags.
Wie erstellen Sie eine llms.txt?
Sie brauchen einen Texteditor und Zugriff auf das Stammverzeichnis Ihrer Website. Einige Shopsysteme und SEO-Plugins erzeugen die Datei auch selbst. Von Hand geht es in fünf Schritten.
- Seiten auswählen. Nehmen Sie die Seiten, die Ihr Angebot und Ihr Unternehmen erklären. Alle Seiten listet bereits die sitemap.xml, die llms.txt ist laut Vorschlag eine kuratierte Übersicht für Sprachmodelle.
- Datei in Markdown schreiben. Speichern Sie die Datei als UTF-8, damit Umlaute richtig ankommen. Die erste Zeile ist eine Überschrift mit dem Namen Ihres Unternehmens, Pflicht ist laut Vorschlag nur diese Zeile. Danach folgen eine Kurzbeschreibung als Zitatblock und Abschnitte mit Linklisten.
- Im Stammverzeichnis ablegen. Die Datei gehört unter https://ihre-domain.de/llms.txt. Dateien in Unterverzeichnissen wie /docs/llms.txt für eine Dokumentation erlaubte bereits die erste Fassung. Seit August 2026 legt der Vorschlag fest, dass eine solche Datei für die Seiten unter ihrem Pfad gilt. Optional verweisen Ihre Seiten auf die Datei, im HTML-Kopf mit
<link rel="describedby" href="/llms.txt">oder im HTTP-Antwortkopf mitLink: </llms.txt>; rel="describedby". - Abruf prüfen. Die Datei muss mit Status 200 antworten und darf keine HTML-Seite sein. Die einzelnen Prüfungen stehen im Abschnitt „So prüfen Sie Ihre llms.txt“.
- Pflegen. Ändern Sie die Datei, sobald wichtige Seiten hinzukommen, umziehen oder wegfallen. Nach einem Relaunch prüfen Sie alle Links darin.
Aufbau am Beispiel unserer eigenen llms.txt
Unsere Datei unter eom.de/llms.txt hat 17 Abschnitte mit 163 Linkeinträgen (Stand 13. November 2026). Der Anfang sieht gekürzt so aus.
# EOM, Effektiv Online-Marketing GmbH

> EOM (Effektiv Online-Marketing GmbH) berät Unternehmen im Mittelstand zu Online- und KI-Marketing und setzt die Maßnahmen mit festem Ansprechpartner um. Seit 2009 mit Sitz in Hannover.

## Unternehmen

- [Fakten über EOM](https://eom.de/grounding-page/): Kerndaten, Leistungen, Lösungen und Begriffsklärungen in einer Übersicht. Markdown-Fassung: https://eom.de/grounding-page.md
- [Kontakt](https://eom.de/kontakt/): Kostenfreies Erstgespräch anfragen. Markdown-Fassung: https://eom.de/kontakt.md

## Kostenlose Tools

- [KI-Sichtbarkeitsbericht](https://eom.de/tools/ki-sichtbarkeit/): Der kostenlose GEO-Check stellt ChatGPT drei Fragen Ihrer Kunden und zeigt, wen es empfiehlt und welche Quellen es nutzt. Ohne Anmeldung.

## Optional

- [Glossar](https://eom.de/glossar/): Begriffe aus Online- und KI-Marketing.
- [Sitemap](https://eom.de/wp-sitemap.xml)
Die Überschrift in der ersten Zeile ist die einzige Pflichtangabe. Der Zitatblock darunter sagt in zwei Sätzen, wer wir sind und wo wir sitzen. Die Links zu Seiten stehen in Listen unter Abschnittsüberschriften, nach dem Doppelpunkt folgt eine kurze Notiz.
Zu vielen Seiten verlinken wir eine Markdown-Fassung, wie es der Vorschlag anregt. Unter den 16 Dateien aus unserer Zählung verlinkt keine eine Markdown-Fassung ihrer eigenen Seiten. Im Abschnitt „Optional“ stehen Links, die ein KI-System bei knappem Platz überspringen kann. So beschreibt ihn auch der Vorschlag, als Brauch und nicht als Regel.
Welche Seiten gehören hinein?
Für Hersteller empfehlen wir die Seiten, die ein Einkäufer für die erste Einordnung braucht. Das ist unsere Empfehlung, der Vorschlag selbst gibt keine Auswahl vor.
- Startseite und eine Seite über das Unternehmen mit Standorten und Zertifizierungen
- Produktbereiche oder Produktgruppen, nicht jedes einzelne Produkt
- Anwendungen und Branchen, für die Sie liefern
- Service, Ersatzteile und Ansprechpartner im Vertrieb
- Datenblätter, Zertifikate und andere Downloads
- Händler- und Standortsuche
- Kontakt
Lassen Sie Seiten weg, die Ihre robots.txt sperrt oder die auf noindex stehen. Eine Liste aller Produkte ohne Notiz ist eher eine zweite Sitemap.
Als Vorlage können Sie diesen Aufbau übernehmen und die Platzhalter ersetzen.
# Name Ihres Unternehmens

> Was Sie herstellen und für welche Branchen. Sitz und Standorte.

## Produkte
- [Produktbereich](https://ihre-domain.de/produkte/bereich/): Einsatz und wichtigste Eigenschaften

## Anwendungen und Branchen
- [Anwendung](https://ihre-domain.de/anwendungen/anwendung/): wofür Kunden Ihre Produkte dort nutzen

## Service
- [Service und Ersatzteile](https://ihre-domain.de/service/): Wartung und Ansprechpartner
- [Downloads](https://ihre-domain.de/downloads/): Datenblätter und Zertifikate

## Unternehmen
- [Über uns](https://ihre-domain.de/unternehmen/): Standorte und Zertifizierungen
- [Kontakt](https://ihre-domain.de/kontakt/): Ansprechpartner im Vertrieb

## Optional
- [Karriere](https://ihre-domain.de/karriere/)
Von Hand, mit Plugin oder Generator
Prüfen Sie vor dem Schreiben, ob unter /llms.txt bereits eine Datei liegt. In unserer Zählung bei 100 Herstellern stammen 7 der 16 gefundenen Dateien erkennbar aus Software. Drei folgen einer Vorlage von Shopify, je eine kommt aus den WordPress-Plugins Yoast SEO, Rank Math und All in One SEO (AIOSEO). Eine weitere erzeugt der Baukasten Wix.
Online-Generatoren lesen Ihre Sitemap oder durchsuchen die Website und schreiben daraus eine Datei. Das Ergebnis ist ein Entwurf, Auswahl und Notizen prüfen Sie danach selbst. Eine von Hand geschriebene Datei zeigt genau die Seiten, die Sie zeigen wollen. Bei vielen Produkten bleibt eine Datei, die Ihr System selbst erzeugt, leichter aktuell.
Brauchen Sie auch eine llms-full.txt?
Für eine Hersteller-Website eher nicht. Eine llms-full.txt enthält den vollständigen Text der wichtigen Seiten in einer Datei, der Vorschlag auf llmstxt.org sieht sie nicht vor. Keine der 16 llms.txt aus unserer Zählung verweist auf eine llms-full.txt.
So prüfen Sie Ihre llms.txt
Rufen Sie die Datei nach dem Hochladen im Browser auf. Den Antwortkopf zeigt der Befehl curl auf der Kommandozeile.
curl -sI https://ihre-domain.de/llms.txt
curl -s https://ihre-domain.de/llms.txt | head -n 20
Der erste Befehl zeigt den Antwortkopf, der zweite die ersten 20 Zeilen der Datei. Leitet die Adresse auf die Fassung mit www um, prüfen Sie die Zieladresse genauso.
- Status 200. Eine Weiterleitung auf die Startseite oder eine 404-Seite zählt nicht. Manche Systeme liefern bei unbekannten Adressen eine HTML-Seite mit Status 200 aus, dann steht im Antwortkopf text/html.
- Textformat. Der Vorschlag schreibt keinen Typ vor, gängig sind text/plain oder text/markdown mit charset=utf-8. eom.de liefert text/plain; charset=utf-8.
- Umlaute. Zeigt die Datei fremde Zeichen, wo ä und ü stehen sollten, stimmt die Kodierung nicht.
- Links. Jeder Link sollte direkt mit Status 200 antworten, ohne Weiterleitung. Ein SEO-Crawler im Listenmodus findet Weiterleitungen und 404-Seiten.
- Lighthouse. Googles Prüfwerkzeug Lighthouse hat bei den Prüfungen für KI-Agenten einen eigenen Punkt für die llms.txt. Er meldet Serverfehler beim Abruf. Fehlt die Datei, gilt der Punkt als nicht anwendbar.
- Validatoren. Online-Validatoren prüfen Überschrift, Abschnitte und Linkformat gegen den Vorschlag. Ob die Auswahl Ihr Angebot zeigt, prüfen sie nicht.
- Server-Log. Ob Crawler die Datei abrufen, zeigt nur das Server-Log. Suchen Sie dort nach Abrufen von /llms.txt und gleichen Sie die IP-Adresse mit der Liste des Anbieters ab.
Was 16 Hersteller in ihre llms.txt schreiben
Von 100 zufällig aus Wikidata gezogenen deutschen Herstellern mit 250 bis 5.000 Beschäftigten hatten am 11. November 2026 16 eine llms.txt. Sieben davon stammen erkennbar aus Software, bei neun ist keine Software erkennbar. Fast alle beginnen mit einer Überschrift.
| Merkmal | Dateien | von |
|---|---|---|
| Überschrift am Anfang | 15 | 16 |
| Überschrift beginnt mit dem Namen des Unternehmens | 12 | 16 |
| Kurzbeschreibung als Zitatblock | 10 | 16 |
| auf Deutsch | 8 | 16 |
| Abschnitt „Optional“ | 5 | 16 |
| Links auf Markdown-Fassungen eigener Seiten | 0 | 16 |
| Verweis auf eine llms-full.txt | 0 | 16 |
Dateien aus Plugins und Shopsystemen
Drei der 16 gefundenen Dateien folgen einer Vorlage von Shopify. Sie sind Anleitungen für KI-Agenten. Sie erklären, wie ein Agent im Onlineshop sucht und einkauft. Das Unternehmen selbst beschreiben sie nicht. Die Datei aus Wix nennt Name, Kurzbeschreibung und Startseite, dazu eine Schnittstelle für KI-Agenten.
Die drei Dateien aus WordPress-Plugins listen Seiten und Beiträge auf, mit 15 bis 259 Links. Zwei davon haben zu fast jedem Link eine Notiz. Eine solche Datei ist ein Anfang. Ob sie die Seiten zeigt, die Ihr Angebot erklären, sehen Sie erst beim Öffnen.
Abweichungen von der Spezifikation
Bei einer der 16 Dateien steht die Überschrift nicht am Anfang, wie es der Vorschlag vorsieht. Die Datei aus Rank Math beginnt mit einem Hinweis auf das Plugin, die Überschrift folgt in der zweiten Zeile. Notizen zu den Links sind laut Vorschlag freiwillig, zu mindestens 80 % ihrer Links haben sie 4 der 9 Dateien ohne erkennbare Software.
Bei den neun Dateien ohne erkennbare Software reicht die Zahl der Links von 0 bis 196. Eine davon setzt zwei Links in den Fließtext, eine andere nennt je Listeneintrag zwei Links. Der Vorschlag sieht einen Link je Eintrag vor. Eine Datei enthält gar keinen Link.
Wer ruft die llms.txt ab?
OpenAI, Anthropic und Google schreiben in ihren Crawler-Dokumentationen nicht, dass ihre Crawler die llms.txt lesen. OpenAI verweist dort auf die eigene llms.txt der Dokumentation. Google schreibt, für die KI-Funktionen der Google-Suche brauche es keine neuen maschinenlesbaren Dateien oder KI-Textdateien. Wir haben deshalb in den Server-Logs von eom.de gezählt, wer die Datei abruft.
| Crawler | Abrufe der llms.txt | Seitenabrufe |
|---|---|---|
| GPTBot (OpenAI) | 0 | 140 |
| OAI-SearchBot (OpenAI) | 0 | 409 |
| ChatGPT-User (OpenAI) | 0 | 295 |
| ClaudeBot (Anthropic) | 1 | 455 |
| Googlebot | 0 | 1.972 |
| Bingbot (Microsoft) | 1 | 1.527 |
| Applebot | 1 | 1.196 |
| Amazonbot, CCBot, Crawler von Meta | nicht geprüft | nicht geprüft |
Die geprüften Crawler von OpenAI und der Googlebot haben die llms.txt im Zeitraum von keiner bestätigten Adresse abgerufen. GPTBot, OAI-SearchBot und Googlebot haben von Adressen ihrer Anbieter zusammen 2.521-mal eine Seite von eom.de abgerufen. Drei andere Crawler aus der Tabelle riefen die Datei je einmal ab. Das gilt für eine Website in gut zwei Wochen, auf anderen Websites kann es anders aussehen.
Warum der Name im User-Agent nichts beweist
Den User-Agent kann jeder Absender frei setzen. Unter den Namen der sieben Crawler aus der Tabelle kamen im Zeitraum 16 Abrufe der llms.txt, 3 davon von bestätigten Adressen. Elf kamen von Adressen, die unter mehreren Crawler-Namen abfragten. Alle Abrufe der llms.txt unter den Namen GPTBot, OAI-SearchBot und Googlebot kamen von solchen Adressen.
Am 9. November um 16:41 Uhr riefen GPTBot, OAI-SearchBot, ClaudeBot und Googlebot die Datei laut User-Agent zum ersten Mal ab, alle in derselben Minute. Das spricht eher für ein Prüfwerkzeug, das die Namen nacheinander durchprobiert. Zählen Sie deshalb nur Abrufe, deren IP-Adresse in der Liste des Anbieters steht. OpenAI, Anthropic, Google, Microsoft und Apple veröffentlichen solche Listen für ihre Crawler. Die Listen stehen unter openai.com/gptbot.json, openai.com/searchbot.json, openai.com/chatgpt-user.json, claude.com/crawling/bots.json, developers.google.com/static/search/apis/ipranges/googlebot.json, www.bing.com/toolbox/bingbot.json und search.developer.apple.com/applebot.json.
Lohnt sich der Aufwand?
Ein Nutzen ist bisher nicht belegt. SE Ranking hat rund 300.000 Domains ausgewertet, 10,13 % davon hatten eine llms.txt. Einen Zusammenhang zwischen der Datei und Zitaten in KI-Antworten fand SE Ranking nicht. Ließ SE Ranking die llms.txt im Modell weg, wurde die Vorhersage genauer.
Trakkr hat im März 2026 37.894 Websites gescannt, die von KI-Systemen zitiert werden. Davon hatten 13,3 % eine llms.txt. Sie wurden im Schnitt 6,8-mal zitiert, Websites ohne Datei 6,7-mal. Beide Auswertungen vergleichen Websites miteinander, eine Ursache prüfen sie nicht.
Die Dokumentation von Lighthouse hält dagegen, ohne die Datei könnten KI-Agenten länger brauchen, um eine Website zu erfassen. Für die Generative Engine Optimization ist die Datei ein kleiner Schritt. Sie kostet wenig Zeit, ein Nachteil ist bisher nicht bekannt. Ob KI-Suchen sie nutzen, ist offen.
Prüfliste für Hersteller vor der llms.txt
Ohne Zugang lesen KI-Crawler weder die llms.txt noch Ihre Seiten. Prüfen Sie deshalb zuerst diese vier Punkte. Die ersten drei betreffen den Zugang, der vierte die Angaben zu Ihrem Unternehmen.
| Prüfpunkt | Hersteller | von |
|---|---|---|
| robots.txt vorhanden | 94 | 100 |
| mindestens einen KI-Crawler in der robots.txt genannt | 10 | 100 |
| Such-Crawler von ChatGPT, Claude oder Perplexity gesperrt | 0 | 100 |
| Startseite über Cloudflare ausgeliefert | 20 | 100 |
| weniger als die Hälfte der Wörter ohne JavaScript sichtbar (unsere Grenze) | 12 | 99 |
| Organisations-Markup im ausgelieferten HTML | 38 | 100 |
| llms.txt vorhanden | 16 | 100 |
Such-Crawler in der robots.txt
Eine robots.txt hatten am 11. November 2026 94 der 100 Hersteller aus unserer Zählung. Darin nannten 10 mindestens einen KI-Crawler, 5 sperrten mindestens einen für die Startseite. Gesperrt waren Crawler, die Daten für KI-Modelle sammeln, etwa GPTBot, ClaudeBot oder CCBot. Die Such-Crawler OAI-SearchBot (ChatGPT), Claude-SearchBot (Claude) und PerplexityBot (Perplexity) sperrte keiner.
Prüfen Sie, ob Ihre robots.txt diese Such-Crawler zulässt. Laut OpenAI lassen sich GPTBot und OAI-SearchBot getrennt steuern. Wer GPTBot sperrt, kann OAI-SearchBot trotzdem zulassen.
Bot-Schutz in Firewall oder CDN
Die Startseiten von 20 der 100 Hersteller wurden am 11. November 2026 über Cloudflare ausgeliefert, erkennbar am Antwortkopf. Ob Cloudflare dort KI-Crawler abweist, haben wir nicht gemessen. Cloudflare hatte im Juli 2025 angekündigt, KI-Crawler ohne Erlaubnis standardmäßig zu sperren. Laut der Cloudflare-Dokumentation vom 2. November 2026 lassen neue Domains Such-, Agenten- und Trainings-Crawler standardmäßig zu.
Welche Regel für Ihre Domain gilt, sehen Sie im Cloudflare-Dashboard unter Security, Settings, Filter „Bot traffic“, Eintrag „AI Crawler and Agent access policies“. Auch andere Firewalls und Bot-Schutzdienste können Crawler abweisen, ohne dass es in der robots.txt steht. Das Protokoll des Bot-Schutzes zeigt, ob er Crawler abweist.
Text ohne JavaScript
Bei 12 von 99 messbaren Startseiten war ohne JavaScript weniger als die Hälfte der Wörter sichtbar. Ein Skript hat die sichtbaren Wörter im Browser einmal mit abgeschaltetem und einmal mit eingeschaltetem JavaScript gezählt. Im Median waren es 405 Wörter ohne und 544 mit JavaScript. Die Grenze bei der Hälfte haben wir selbst gesetzt, sie ist keine Norm. Vorab festgelegt war zusätzlich ein Unterschied von mindestens 100 Wörtern, damit sind es 11 von 99.
Was im ausgelieferten HTML steht, liest jeder Crawler. Für den Rest muss er die Seite wie ein Browser ausführen. Prüfen Sie Ihre Startseite mit curl oder mit abgeschaltetem JavaScript im Browser. Fehlen Produktnamen oder Beschreibungen, lädt Ihr System sie erst per JavaScript nach.
Organisations-Markup
Organisations-Markup, also schema.org-Typen wie Organization, lieferten am 11. November 2026 die Startseiten von 38 der 100 Hersteller im HTML aus. Davon nutzten 36 JSON-LD und 2 Microdata. Bei 2 weiteren erschien es erst nach JavaScript. Gezählt haben wir nur auf der Startseite.
Organisations-Markup nennt Name, Logo, Adresse und Profile des Unternehmens in maschinenlesbarer Form. Laut Vorschlag kann die llms.txt auf solches Markup verweisen.
Dann die llms.txt
Sind diese vier Punkte geklärt, folgt die llms.txt. Ob KI-Dienste Ihre Website lesen können, zeigt der kostenlose KI-Sichtbarkeitsbericht in rund 30 Sekunden. Im GEO-Audit prüfen wir Crawler-Zugang und strukturierte Daten Ihrer Website. Dazu vergleichen wir, ob ChatGPT, Microsoft Copilot, Gemini und Googles KI-Übersichten Sie oder drei Ihrer Wettbewerber nennen.
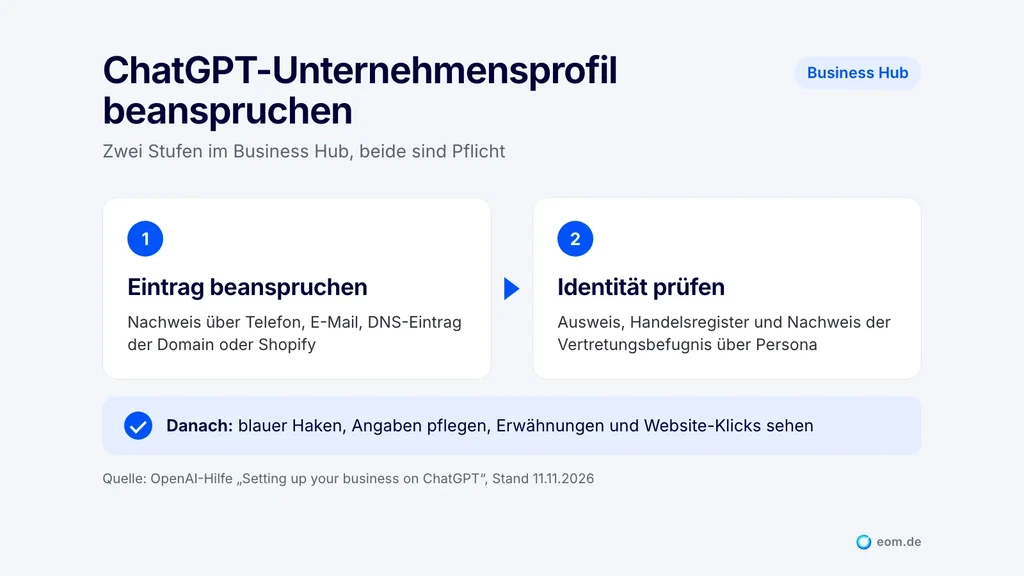
Wie ChatGPT Anbieter auswählt, beschreibt unser Beitrag zu ChatGPT SEO. Seit dem 10. November 2026 testet OpenAI außerdem ein Unternehmensprofil in ChatGPT. Ob Unternehmen in Deutschland es bereits beanspruchen können, hängt von der Freischaltung durch OpenAI ab.
So haben wir gemessen
Zählung bei 100 Herstellern
Grundlage der Zählung ist Wikidata, eine frei nutzbare Wissensdatenbank, Stichtag war der 11. November 2026. Die Abfrage nach Organisationen in Deutschland mit 250 bis 5.000 Beschäftigten und eigener Website ergab 1.481 Einträge, darunter auch Kliniken und Behörden. Nach festen Begriffsregeln blieben davon 193 Einträge übrig. Bei einer Einzelprüfung vor der Messung fielen 14 weitere heraus, etwa Händler und Dienstleister. Aus den übrigen 179 Einträgen hat das Skript in einer Zufallsreihenfolge mit festem Startwert 109 abgerufen, bis 100 Startseiten auswertbar antworteten.
Je Website hat das Skript die Startseite, die robots.txt und die llms.txt abgerufen. Gemessen wurden Nennung und Sperre von 14 Kennungen für KI-Crawler in der robots.txt, Cloudflare im Antwortkopf, strukturierte Daten auf der Startseite und der Text ohne JavaScript. Neun abgerufene Websites waren nicht auswertbar.
Server-Logs von eom.de
Die Server-Logs von eom.de haben wir für den 29. Oktober bis 13. November 2026 ausgewertet. Gezählt sind nur erfolgreiche Abrufe von Crawlern mit Status 200, Besucher und ihre IP-Adressen sind nicht Teil der Auswertung. Als bestätigt gilt ein Abruf, wenn die IP-Adresse in der veröffentlichten Liste des Anbieters steht. Die Listen haben wir am 13. November 2026 geladen.
Grenzen und Daten zum Download
Gemessen haben Skripte, die Zahlen der Zählung haben zwei getrennte Prüfläufe nachgerechnet. Sie gelten für diese 100 Hersteller und für eom.de in diesem Zeitraum. Wikidata ist kein vollständiges Register und führt eher bekannte Unternehmen. Die Beschäftigtenzahlen stammen aus unterschiedlichen Jahren. Von den neun nicht auswertbaren Websites antworteten drei mit 404 und drei gar nicht, je eine mit 429, 500 oder einer Weiterleitung. Darunter können Websites mit Bot-Schutz sein. Auf andere Hersteller lassen sich die Zahlen nicht übertragen.
Die Auswahlregeln und die Ergebnisse als Tabelle stehen zum Download. Die Liste der Hersteller veröffentlichen wir nicht, weil wir keine einzelnen Unternehmen öffentlich bewerten. Ohne die Liste lässt sich die Ziehung nur mit der Abfrage in den Auswahlregeln nachstellen, Wikidata ändert sich laufend.
Häufige Fragen
Wo muss die llms.txt liegen?
Im Stammverzeichnis Ihrer Domain, also unter https://ihre-domain.de/llms.txt. Weitere Dateien in Unterverzeichnissen sind möglich. Seit der Fassung vom August 2026 gilt eine solche Datei für die Seiten unter ihrem Pfad. Gibt es mehrere, gilt die Datei mit dem genauesten Pfad.
Welches Format hat eine llms.txt?
Eine llms.txt ist eine Textdatei in Markdown, gespeichert als UTF-8. Pflicht ist nur eine Überschrift mit dem Namen der Website. Üblich sind danach eine Kurzbeschreibung als Zitatblock und Abschnitte mit Linklisten, je Link mit kurzer Notiz.
Kann ein Plugin die llms.txt automatisch erstellen?
Ja. In unserer Zählung bei 100 Herstellern stammen 7 von 16 Dateien erkennbar aus Software, etwa aus Yoast SEO, Rank Math, AIOSEO, Wix oder einer Vorlage von Shopify. Prüfen Sie danach, ob die Datei mit einer Überschrift beginnt und die Seiten zeigt, die Ihr Angebot erklären.
Wie oft sollten Sie die llms.txt aktualisieren?
Immer dann, wenn wichtige Seiten hinzukommen, umziehen oder wegfallen. Nach einem Relaunch prüfen Sie alle Links darin auf Weiterleitungen und 404-Seiten. Ein Plugin, das die Datei aus Ihrem System erzeugt, kann sie automatisch aktuell halten.
Muss die llms.txt in der robots.txt stehen?
Nein. Der Vorschlag auf llmstxt.org sieht keinen Eintrag in der robots.txt vor. Die Fassung vom August 2026 sieht dafür einen Verweis vom Typ describedby im HTML-Kopf der Seiten oder im HTTP-Antwortkopf vor.
Woran erkennen Sie, ob KI-Crawler Ihre llms.txt abrufen?
Am Server-Log. Suchen Sie nach Abrufen von /llms.txt und gleichen Sie die IP-Adresse mit der Liste des Anbieters ab. Der Name im User-Agent allein beweist nichts, weil jeder Absender ihn frei setzen kann.
Geschrieben von
Lukas Becker
SEO und GEO bei EOM
Lukas Becker arbeitet bei EOM im Bereich SEO und GEO und verantwortet das GEO-Audit und die Relaunch-Absicherung. Er berät Unternehmen dazu, wie sie bei Google gefunden und in den Antworten von ChatGPT oder Gemini genannt werden. Website-Relaunches begleitet er aus SEO-Sicht. Außerdem betreut er die Redaktion von EOM Insights.
Begriffe aus diesem Beitrag
Zum Glossar- llms.txt
- Die llms.txt ist eine vorgeschlagene Markdown-Datei im Stammverzeichnis einer Website (beispiel.de/llms.txt), die Sprachmodellen (Large Language Models, LLMs) kompakt zeigt, welche Inhalte wichtig sind und wo sie liegen.
- robots.txt
- Die robots.txt ist eine Textdatei im Stammverzeichnis einer Website, die Crawlern von Suchmaschinen und KI-Anbietern mitteilt, welche Bereiche sie abrufen dürfen.
- KI-Agent
- Ein KI-Agent ist ein System auf Basis eines Sprachmodells, das eine Aufgabe selbstständig in Schritte zerlegt, dafür Tools wie Websuche, Browser oder Software-Schnittstellen nutzt und über den nächsten Schritt selbst entscheidet, etwa beim Recherchieren, Vergleichen oder Bestellen.
- Strukturierte Daten (Schema.org)
- Strukturierte Daten sind maschinenlesbare Angaben im Quellcode einer Seite, meist nach dem Vokabular von Schema.org und im Format JSON-LD, die Suchmaschinen und KI-Systemen eindeutig mitteilen, worum es geht: etwa Produkt, Preis, Bewertung, Veranstaltung, Stellenanzeige oder Organisation.
Weiterlesen